


116 експериментів перевірили надійність підходу
Дослідники з Університету Маямі створили математичний метод, який дозволяє великим мовним моделям оцінювати власну невпевненість. Про розробку детально розповідає Tech Xplore, і команда опублікувала результати серії тестів на практичних завданнях.
Метод оцінює стабільність ймовірностей, на основі яких модель обирає слова, і порівнює поведінку при невеликих варіаціях. Усього під час оцінки було проведено 116 експериментів на математичних задачах і наборах запитань та відповідей.
| Показник | Значення |
|---|---|
| Експерименти | 116 |
| Сімейства моделей | 3 |
| Статистичний підхід | 1 |
3 сімейства мовних моделей опитані в тестах
Тестування відбувалося на моделях сімейств Mistral, Falcon і Llama. Дослідники одразу перевіряли не лише кінцеві відповіді, а й внутрішні ймовірності вибору слів, щоб виявити нестабільність.
Таке порівняння дозволило побачити, як різні архітектури реагують на ті самі задачі. Результати показали, що аналіз ймовірностей дає більше інформації про невпевненість, ніж просте порівняння варіантів відповідей при багаторазових запитах.
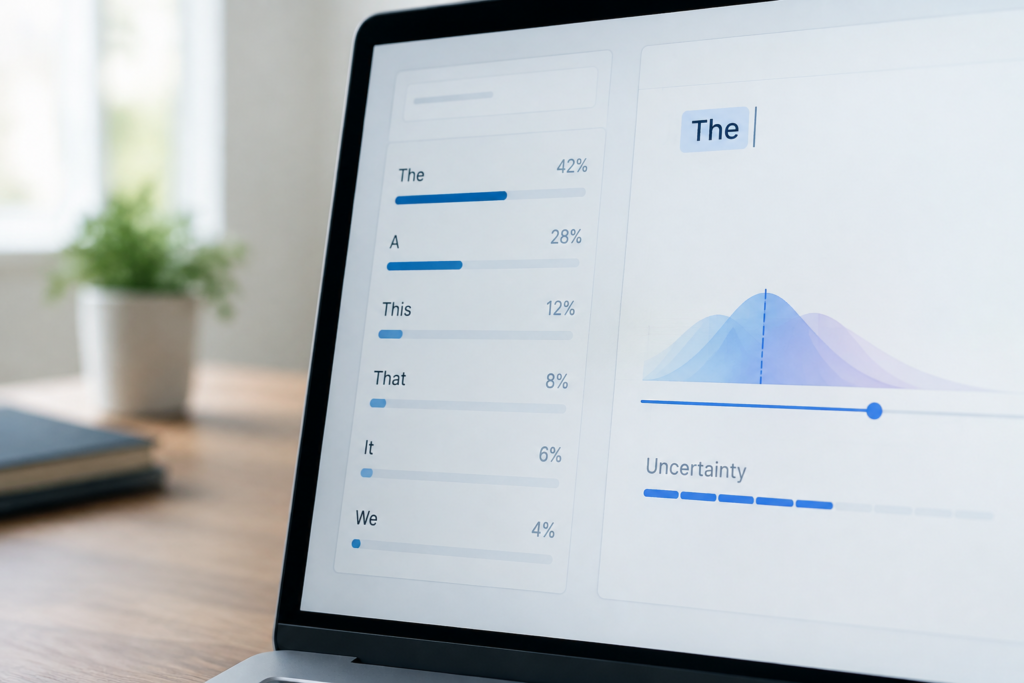
1 статистичний підхід аналізує незапитані варіанти відповідей
Ключова ідея методу в тому, щоб враховувати ймовірність відповідей, які модель могла б згенерувати, але не показала користувачу. Статистичний підхід оцінює ймовірність існування ще не спостережуваних варіантів і вимірює, наскільки коливаються ці ймовірності при невеликих змінах.
За задумом авторів, це дозволить ШІ повідомляти користувачу про невпевненість, пропонувати кілька можливих варіантів або просити додатковий контекст перед остаточною відповіддю. Один з авторів пояснив мету словами «Кінцева мета — щоб LLM могла сказати: „Я не впевнена, але ось найімовірніші відповіді, які в мене є“, або навіть попросити більше контексту перед відповіддю».
Що показали результати проти попередніх підходів
У підсумку автори відзначили, що новий метод перевершив їхні попередні підходи до виявлення ненадійних відповідей. Це стосується точності і раннього виявлення нестабільних прогнозів у відповідях моделей.
Технологія ще не є готовою для миттєвого впровадження у всі чат-боти, але дослідження дає практичний шлях до того, щоб ШІ не видавав упевнені, але хибні твердження. Наступні кроки полягатимуть в розширенні тестів і інтеграції з реальними системами відповіді.